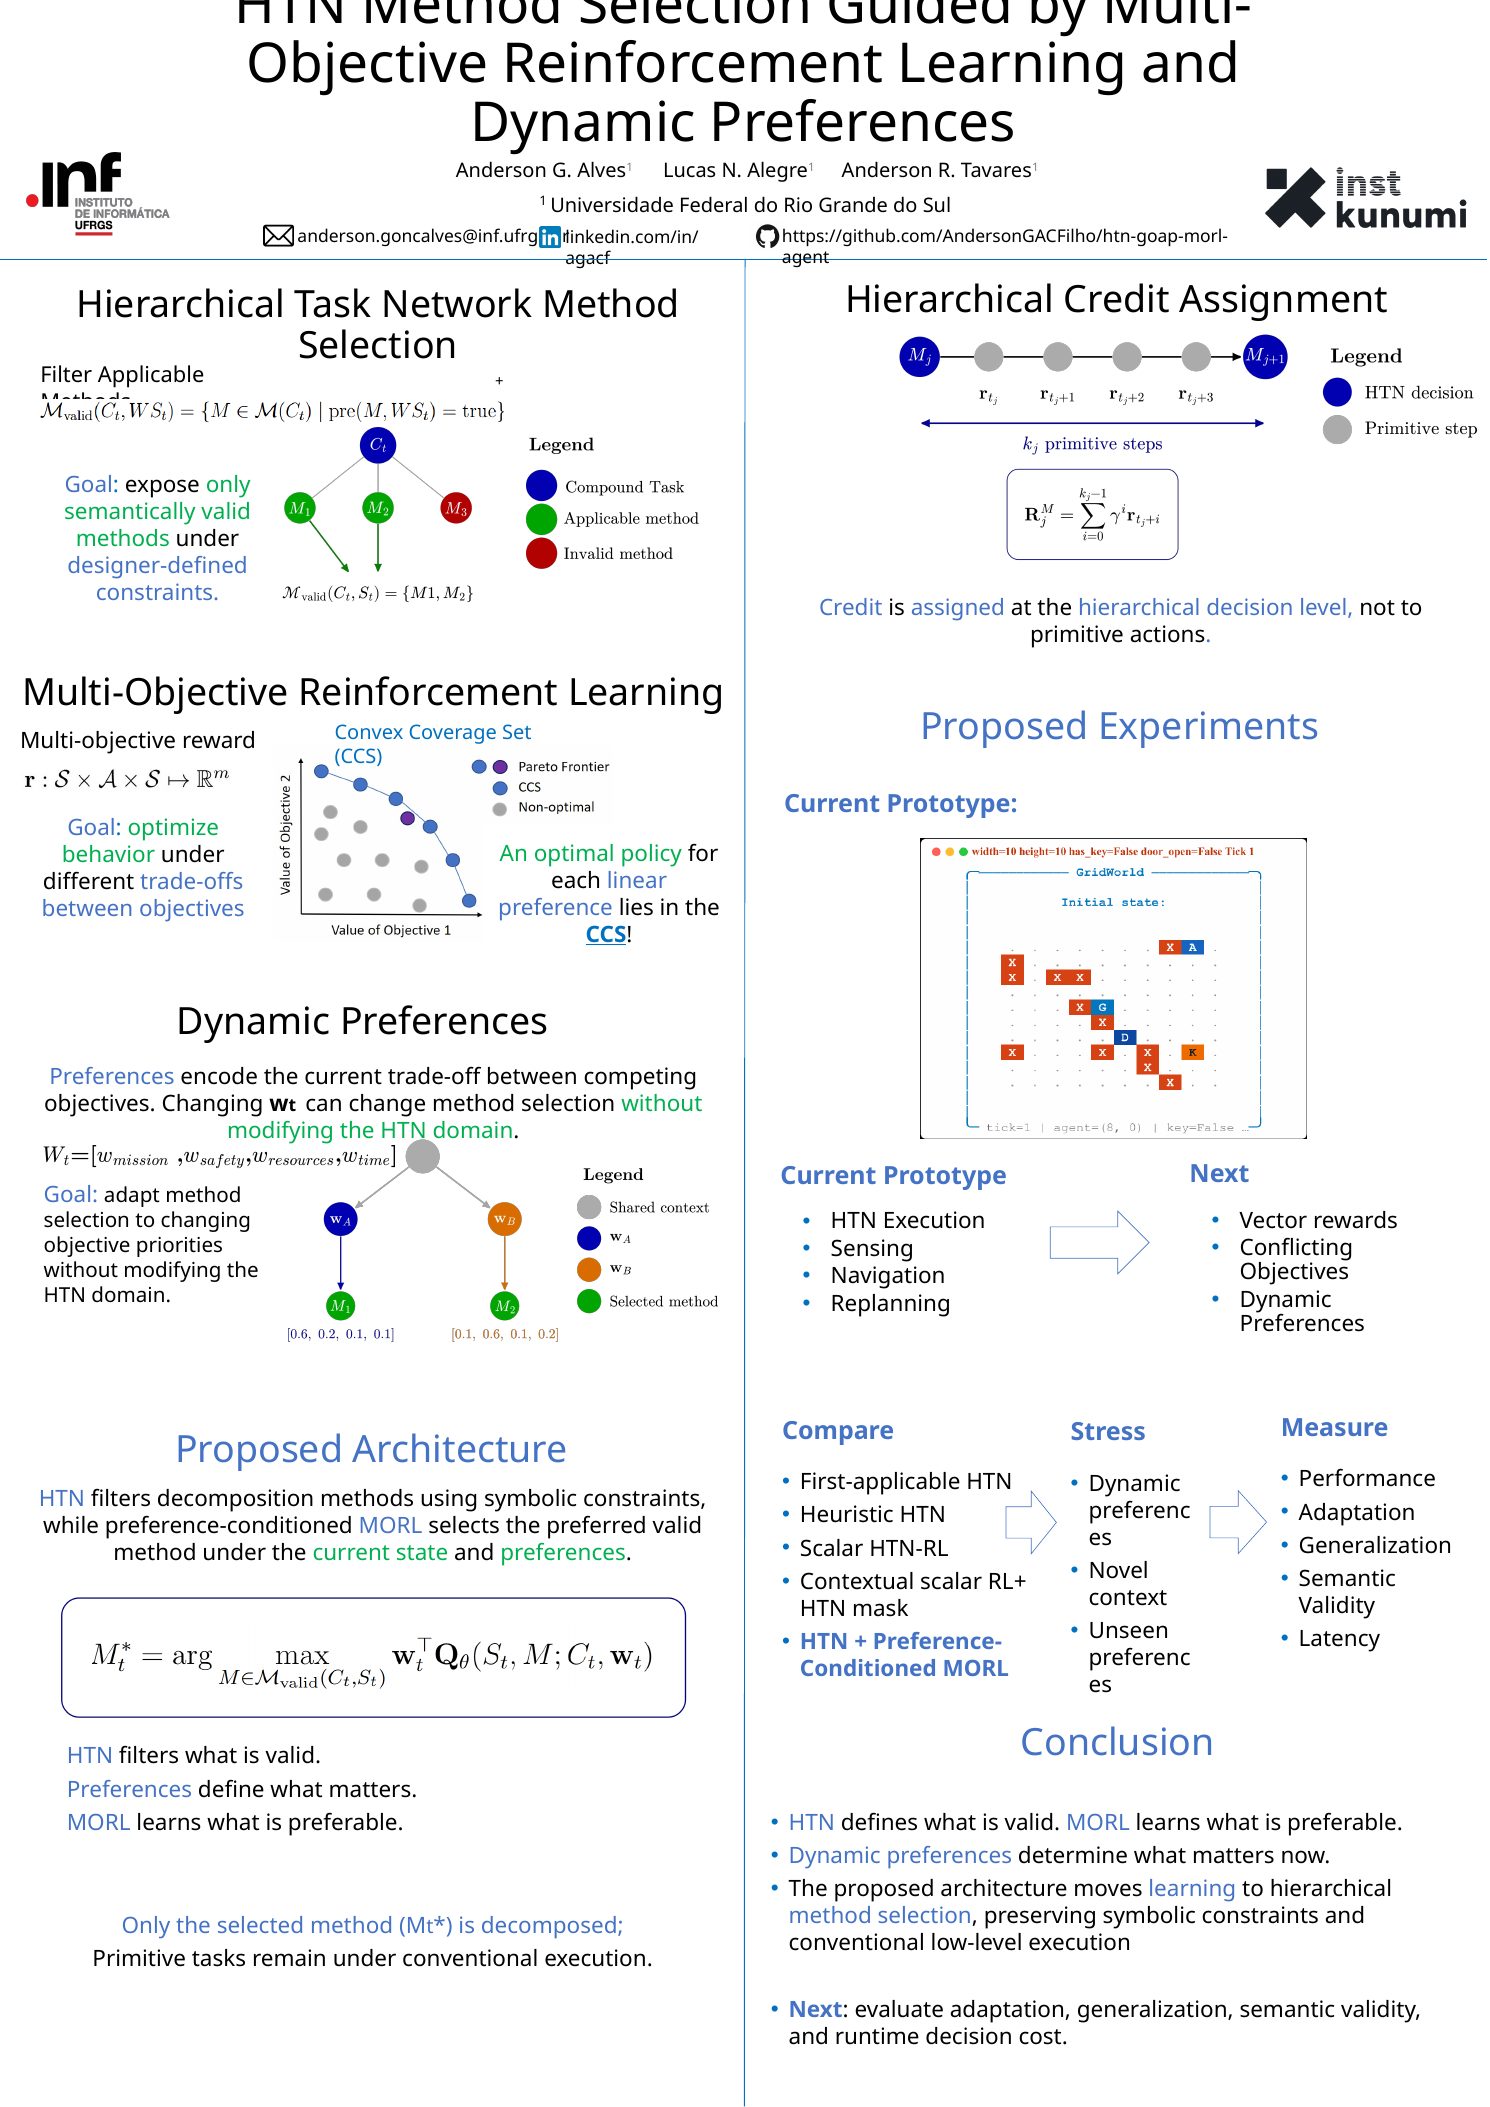
Filtragem: o domínio diz o que é legal
Em cada tarefa composta, o HTN expõe apenas os métodos cujas pré-condições valem no estado atual. Tudo o que é semanticamente inválido sob as restrições escritas no domínio sai de cena antes de o aprendizado ser consultado.
Aprendizado: MORL condicionado a preferências escolhe entre os sobreviventes
Cada recompensa é um vetor com uma entrada por objetivo, então objetivos em conflito ficam separados e nunca colapsam num número só. Condicionar a política a um vetor de preferências dá um único agente que cobre o espaço de trade-offs: para toda preferência linear existe uma política ótima no conjunto de cobertura convexa.
Preferências: o que importa, agora
O vetor de pesos carrega o trade-off atual entre missão, segurança, recursos e tempo. Mudá-lo muda o método selecionado sem tocar no domínio HTN, então se adaptar a uma prioridade nova não exige reescrever nada.
Com dois objetivos, progresso e sobrevivência, e retornos estimados de [0,8; 0,2] para um método e [0,5; 0,5] para outro, os pesos [0,8; 0,2] escolhem o primeiro. Mudando para [0,2; 0,8], o agente escolhe o segundo. Os números são inventados para o exemplo.
Crédito onde a decisão foi tomada
Só o método selecionado é decomposto, e as tarefas primitivas seguem em execução convencional. O crédito vai para a decisão hierárquica que escolheu o método. Isso mantém o sinal de aprendizado legível e me deixa explicar por que o agente fez o que fez.